SSDもオンデマンドで使う時代へ! LIQID ストレージ・プーリングが実現する柔軟なストレージ活用
~高騰するメモリ・SSD価格への新しい対応策 コンポーザブル・インフラストラクチャで実現するストレージ・プーリング~
- 高騰するメモリ・SSD価格、これまでのサーバ構成で本当に効率的な投資ができるのか?
生成AIの急速な普及により、データセンターを取り巻くハードウェア環境は大きく変化しています。GPUをはじめとするAIアクセラレータの需要拡大は、GPUそのものだけでなく、HBM、DDR5 DRAM、そしてNVMe SSDといったメモリ・ストレージ製品にも大きな影響を及ぼしています。
AIシステムの構築に必要なこれらのコンポーネントは、供給能力の制約と需要の急増によって価格上昇が続いており、システム投資に占めるメモリ・ストレージのコストも無視できないものになっています。特に、AIシステムではGPUの性能を最大限に引き出すため、大容量のメモリや高速ストレージが求められます。そして、従来のサーバ構成では、こうしたリソースをサーバ単位で搭載することが一般的でした。
例えば、あるサーバでは大容量のNVMe SSDを搭載しているのにその容量を使いきれず相当量の空きがあるのに、隣のサーバではストレージ容量が不足しているといったことがあるわけです。つまり、サーバごとに必要な最大容量を見込んでSSDを購入した場合、運用次第ではシステム全体では余剰リソースが発生してしまう可能性があるのです。
メモリやSSDの価格が高騰する現在、このような設備投資のあり方を見直すことは、ITインフラのコスト最適化において重要なテーマになっています。
必要なリソースを、必要なサーバに、必要なときだけ割り当てる。この考え方をストレージに適用するのが、LIQIDのストレージ・プーリングです。
- ストレージ・プーリング ― SSDをサーバから切り離して共有する
LIQIDが提供するコンポーザブル・ディスアグリゲーテッド・インフラストラクチャ(CDI)は、サーバに固定的に搭載されていたGPUやメモリ、ストレージなどのPCIeリソースをサーバ本体から分離し、必要に応じてホストサーバへ動的に割り当てることを可能にする技術です。
ストレージ・プーリングは、その技術をNVMe SSDに適用したソリューションです。
従来のサーバ構成では、NVMe SSDはサーバ内部のU.2/U.3ベイやPCIeスロットなどに搭載され、そのサーバ専用のストレージ・スペースとして利用されます。これに対し、LIQIDのストレージ・プーリングでは、NVMe SSDを別に用意する専用の拡張シャーシに集約し、PCIeファブリック・ネットワーク(PCIeバスを筐体外部に延長したネットワーク)を介してホストサーバと接続します。そして、LIQID Matrixソフトウェアによって、必要なSSDを必要なホストサーバへ割り当てます。この仕組みによって、物理的にはサーバの外部に集約されているNVMe SSDを、あたかもサーバ内部に存在するPCIe接続NVMe SSDのように利用することができます。
ここで重要なのは、一般的なネットワークストレージとは異なるアプローチであることです。
一般的なNASやSANでは、ネットワークを介してストレージにアクセスします。一方、LIQID ストレージ・プーリングはPCIeファブリックを利用するため、ホストサーバはあたかも内蔵のPCIeデバイスとしてストレージを利用できる構成を実現します。加えて、ストレージを単にネットワーク経由で共有するのではなく、そのストレージをプールして複数のホスト間で共有し、オンデマンドで瞬時に再構成することができるという点が大きな特徴です。
- LQD4500 × EX-5410P ― 高性能NVMe SSDを共有リソースに
このストレージ・プーリングを実現する構成例として、LIQIDのNVMe SSD「Element LQD4500」とPCIe拡張シャーシ「EX-5410P」の組み合わせをご紹介します。
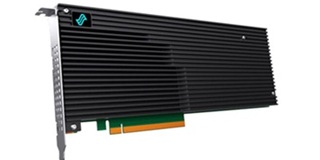
LIQID LQD4500 IOアクセラレータ(NVMe SSD)
LQD4500は、PCIe Gen4/5 x16インターフェースを採用したAdd-in Card(AIC)型の高性能NVMe SSDです。一般的な2.5インチSSDとは異なり、PCIeスロットに直接搭載するカード型の製品であり、基板上に8枚のM.2 SSDを搭載しており高いストレージ密度と優れたI/O性能を実現します。
主な仕様は以下のとおりです。
最大32TBという大容量に加え、26GB/sを超える読み出し帯域幅を持つLQD4500は、大容量データを高速に処理するAI、HPC、データ分析などの用途に適したストレージデバイスです。
| 項目 | 仕様 |
| インターフェース | PCIe Gen4 x16 |
| プロトコル | NVMe 1.3 |
| 最大容量 | 32TB |
| 最大読み出し性能 | 26GB/s超 |
| ランダム読み出し性能 | 最大400万IOPS |
| レイテンシ | 約10μs |
| フォームファクタ | FHFL PCIe AIC |
| データ保護 | 電源障害時のデータ保護機能 |
このLQD4500を収容するEX-5410Pは、PCIe Gen5対応のファブリック(PCIeスイッチ・コントローラ)統合型拡張シャーシです。最大10枚のダブルワイドPCIeデバイスを搭載でき、PCIeファブリックを通じてホストサーバにリソースを提供します。
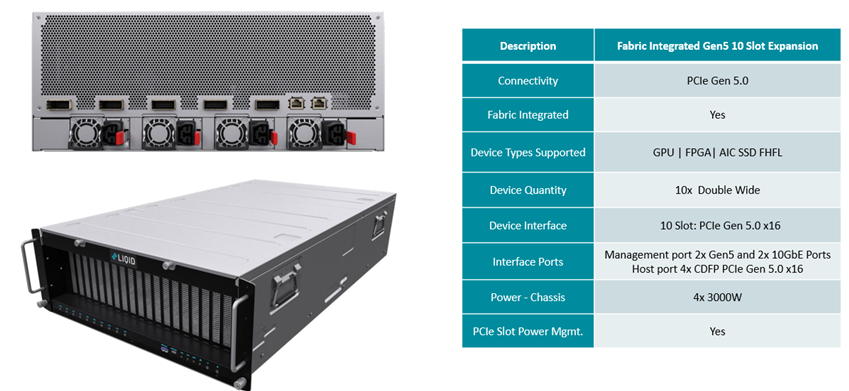
LIQID CDI PCIe拡張シャーシ EX-5410P
EX-5410Pの主な特徴は以下のとおりです。
– 最大10スロットのPCIe Gen5対応
– 最大512GB/sの外部PCIe帯域幅
– LIQID PCIeファブリックとの統合
– LIQID MatrixによるPCIeデバイスの動的割り当て
このEX-5410PにLQD4500を複数枚(最大 10枚)搭載することで、高性能NVMe SSDを集約したストレージプールの構築が可能です。
※LQD4500はPCIe Gen4 x16製品です。EX-5410PのPCIe Gen5対応スロットに接続した場合も、デバイス側のPCIe Gen4仕様に基づいて動作します。
- ストレージ・プーリングの構成イメージ
例えば上図のように、EX-5410Pに10枚のLQD4500を搭載し、PCIeファブリックを介して4台のホストサーバと接続します。
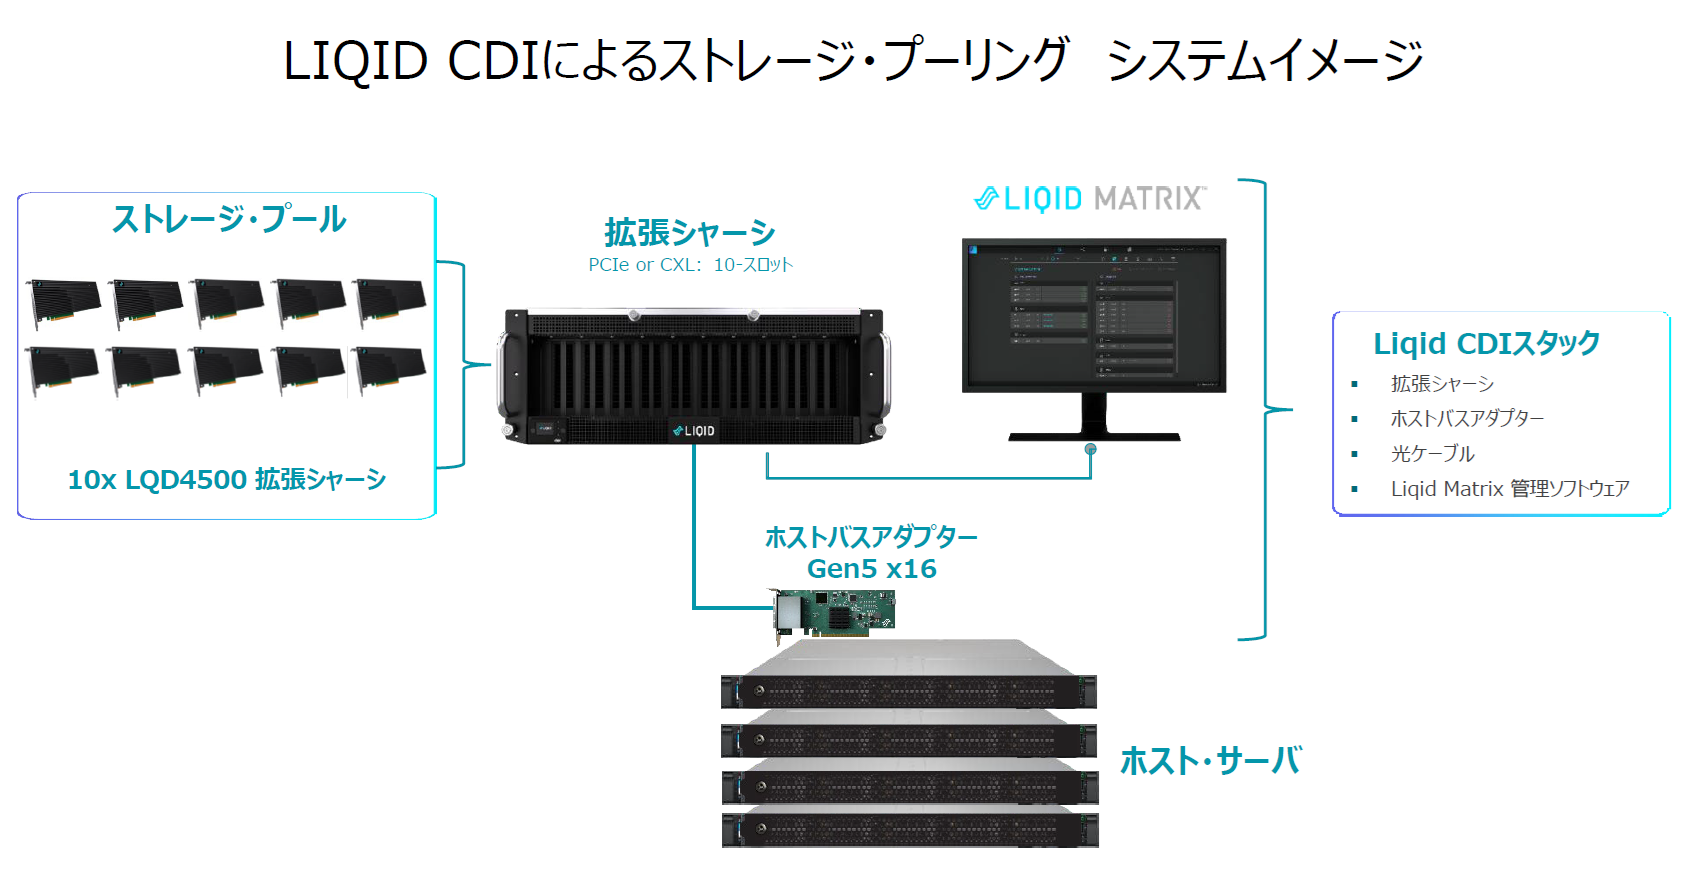
このストレージ・プーリング・システムを統御するLIQID Matrixを利用することで、ストレージプールにあるNVMe SSDを任意のホストサーバに動的に割り当て、そのサーバからPCIe接続のNVMeデバイスとして利用できます。
これにより、従来であれば、各サーバに個別に搭載する必要があった高性能NVMe SSDを、物理的に集約して管理できるようになります。そして、ワークロードやストレージ需要の変化に応じて、SSDの割り当てを変更することが可能になります。LQD4500には8枚のM.2 SSDが搭載されており、ホストサーバへの割り当て(コンポーズ)はこのM.2 SSDが最小単位となります。
SSDをサーバに固定するのではなく、SSDをプールしてサーバに割り当てる。
これがLIQID ストレージ・プーリングの基本的な考え方です。
- AI時代の新たな課題「GPU Memory Wall」とストレージ・プーリング
ストレージ・プーリングが特に注目される分野の一つが、AIシステムです。
大規模言語モデル(LLM)をはじめとする生成AIでは、モデルの大規模化とともに、GPUが処理するデータ量も急速に増加しています。
GPUの演算性能が向上する一方で、その演算能力を十分に活用するためには、GPUに対して大量のデータを継続的に供給する必要があります。
ところが、GPUの処理能力に対してメモリ容量やメモリ帯域幅が十分でない場合、GPUがデータの到着を待つ状態が発生します。
これが、いわゆる「Memory Wall(メモリウォール)」問題です(この問題についての弊社の技術コラムはこちら)。
特にLLMの推論では、モデルのパラメータだけでなく、会話の履歴やコンテキストを保持するKVキャッシュなど、大量のデータをメモリ上に保持する必要があります。
利用者数や同時接続数が増えるほど必要なメモリ容量は増大し、GPUに搭載されたHBMだけでは十分な容量を確保できないケースもあります。
この問題に対しては、GPUの増設だけでなく、HBM、システムDRAM、NVMe SSDを適切に組み合わせた階層型のメモリアーキテクチャが重要になります。
例えば、階層を成すメモリ・デバイスには以下のような役割分担が考えられます。
|
メモリ階層 |
主な役割 |
| GPU HBM | GPUが高速にアクセスする演算用データ、頻繁に利用するKV Cache |
| システムDRAM | HBMに収まらないデータ、CPU側の処理領域、キャッシュ |
| NVMe SSD | 大容量データセット、モデルデータ、チェックポイント、検索用データ、退避データ |
もちろん、NVMe SSDはHBMやDRAMと比較するとアクセスレイテンシや帯域幅の面で差があります。そのため、GPUが頻繁にアクセスするデータを単純にNVMe SSDへ移せばよいというわけではありません。しかし、すべてのデータを高価なHBMやDRAMに保持する必要もありません。
アクセス頻度や処理特性に応じてデータを適切な階層に配置することで、限られたGPUメモリをより重要な処理に集中させることができます。
(このレイテンシや帯域幅のギャップを埋めるためにCXLメモリという新しいメモリ製品が登場しています。紙面の都合でここでは多くを書けませんが、ご関心いただける方はこちらをご覧ください)
例えば、以下のようなAIワークロードでNVMe SSDの活用が考えられます。
– RAG(Retrieval-Augmented Generation)で利用する大規模なベクトルデータベース
– AIモデルや学習データセットの高速読み出し
– 学習時のチェックポイント保存・復元
– GPUメモリに収まりきらないデータの退避領域
– 推論時のキャッシュやKVキャッシュの階層化
つまり、ストレージ・プーリングはGPUのメモリウォール問題を直接解消するものではありませんが、AIシステム全体のデータ配置とストレージ利用を最適化することで、GPUリソースをより有効に活用することを可能にします。
さらに、LIQIDの強みは、このストレージ・プーリングをGPUプーリングやCXLメモリ・プーリングと組み合わせられることです。
GPU、DRAM、CXLメモリ、NVMe SSDという異なるリソースを、ワークロードに応じて柔軟に組み合わせることができれば、AIシステムの性能品質を大幅に改善できる可能性があります。
- メモリ・SSD高騰時代だからこそ求められる「所有から共有へ」
現在のようにメモリやSSDの価格が高騰している状況では、ハードウェアの購入数量を加減することだけでなく、購入したリソースをいかに効率よく利用するかが重要になります。
例えば、4台のサーバにそれぞれNVMe SSDを搭載する構成を考えてみます。
従来の構成では、各サーバが必要とする最大容量を見込んでSSDを購入する必要があります。
しかし、実際のワークロードでは、サーバごとにストレージ使用量が異なり、例えば下図では、それぞれのサーバに7.68TBのNVMe SSDが搭載されていますが、あるサーバでは容量が不足している一方、別のサーバでは大きな空き容量が残っているという状況も起こり得ます。しかし、SSDを集約して共用するストレージ・プールを構築すれば、必要な時に必要な容量をサーバへ割り当てることで、こうしたリソースの偏りを緩和できます。同じく下図の例では7.68TB x 4 = 30.72TBのプールから一番多いサーバで13.6TB、少ないサーバで1.2TBと、それぞれの使用状況に応じて動的に割り当てることができ(コンポーズ)、使い終わったら再びプールに戻します。
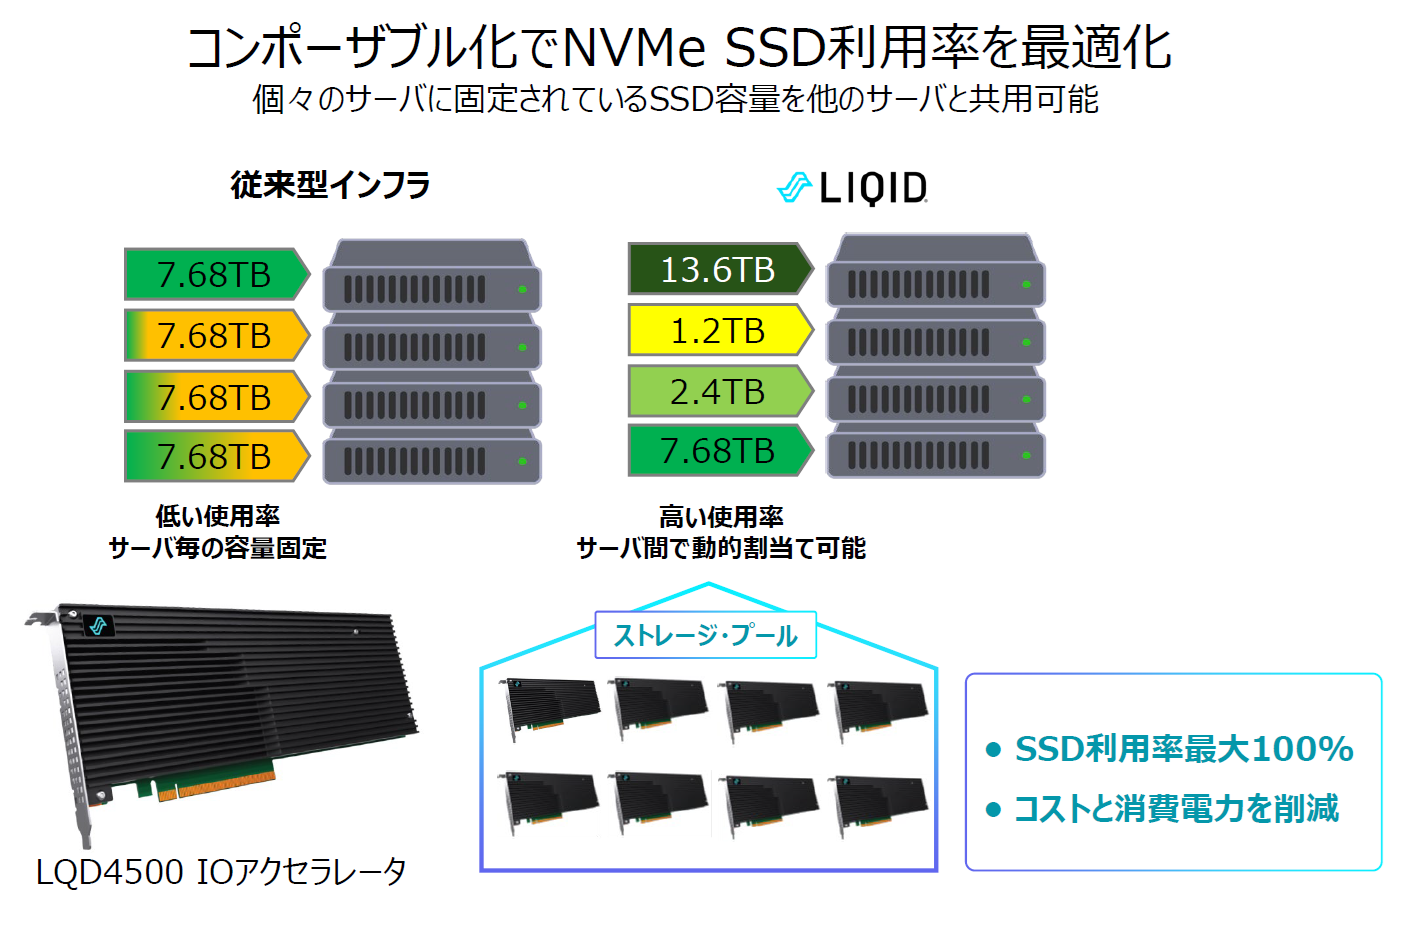
また、プロジェクトごとに異なるストレージ容量を要求されるAI開発環境でも、必要な期間だけストレージを割り当て、プロジェクト終了後にはプールに戻して別の用途に再利用するといった運用が可能になります。これにより、特定のサーバに固定されていたSSDを、システム全体で有効活用できるようになります。
もちろん、実際の導入にあたっては、必要なストレージ容量、性能要件、PCIeファブリックの帯域幅、同時利用するホスト数などを考慮した設計が必要です。
しかし、ストレージをサーバごとに固定する従来の考え方から脱却することで、設備投資の柔軟性とリソース利用効率を高めることができます。
高価なSSDを必要以上に購入するのではなく、保有するSSDを最大限に活用する。
これからのAIインフラに求められる重要な考え方ではないでしょうか。
- GPUだけではない。PCIeリソースを自由に組み合わせるLIQID CDI
LIQIDのコンポーザブル・ディスアグリゲーテッド・インフラストラクチャ(CDI)は、GPUの共有化という提供価値で知られていますが、実際にはGPUに限らずあらゆるPCIeデバイスを対象とする技術です。
PCIeファブリックを基盤として、GPU、NVMe SSDなどのPCIeデバイスをプールし、必要に応じてホストサーバへ割り当てることができます。
さらに、先述のCXLメモリを利用したメモリ・プーリングにも対応しており、従来のサーバ構成では難しかった大容量メモリの柔軟な割り当ても可能にしています。
これらを組み合わせることで、例えば次のような構成を実現できます。
– AIモデルの学習時には、GPUと高速NVMe SSDを重点的に割り当てる。
– 大規模なAI推論では、GPUに加えて十分なDRAM容量を確保する。
– RAGやデータ分析では、大容量のNVMe SSDを重点的に割り当てる。
– ワークロード処理が完了したら、使用していたリソースをプールに戻し、別のサーバで再利用する。
つまり、サーバという固定的なハードウェア構成にワークロードを合わせるのではなく、 ワークロードに合わせて必要なハードウェア構成を組み立てる(ベアメタルサーバを構成する)という考え方です。
AIの進化に伴い、必要とされるGPU性能、メモリ容量、ストレージ容量はワークロードごとに大きく異なってきています。
こうした変化に対応するためには、従来のサーバ単位のリソース管理から、データセンター全体でリソースを最適化するアーキテクチャへの転換が求められています。
LIQID CDIは、その実現に向けた有力な選択肢の一つです。
- おわりに ― SSDも「必要なときに、必要なだけ」使う時代へ
これまで、サーバのCPUやメモリ、ストレージは、それぞれのサーバに固定的に搭載することが当たり前でした。しかし、AIの普及によってハードウェアの需要が急増し、GPU、DRAM、SSDなどの調達コストが大きな課題となる現在、従来の固定的なリソース配置は必ずしも最適とは言えなくなっています。
LIQID ストレージ・プーリングは、NVMe SSDをサーバから切り離してプール化することで、必要なときに必要な容量を必要なサーバへ割り当てることを可能にします。
さらに、GPUプーリングやCXLメモリ・プーリングと組み合わせることで、AIシステムに求められる多様なリソースを柔軟に構成できるようになります。
GPUをプールする。メモリをプールする。そして、SSDもプールする。
ハードウェアを個々のサーバに閉じ込めるのではなく、データセンター全体で共有可能なリソースとして捉え直す。それが、これからのAIインフラに求められるコンポーザブル・インフラストラクチャの考え方です。
弊社では、LIQID CDIを通じて、GPU、メモリ、ストレージの柔軟な活用による次世代ITインフラの構築をご提案していますので、是非お気軽にお問合せください。