“コンポーザブルKubernetes” : LIQID CDIによる動的GPUオーケストレーション
今日の生成AIや大規模言語モデル(LLM)の急速な普及に伴い、企業には拡張性、柔軟性、そして高いコスト効率を兼ね備えたインフラストラクチャが求められています。LIQID Composable Disaggregated Infrastructure(CDI)とKubernetesを統合することで、AIワークロードの需要に応じた「GPUの動的な構成(Compose)」が可能になります。
本記事では、LIQID CDI環境においてKubernetesがどのように連携し、GPUリソースの動的な割り当てや共有を実現しているのか、その技術的な仕組みと利点を解説します。
- 全体像:KubernetesによるGPUの動的オーケストレーション
従来、KubernetesクラスターでGPUを活用する場合、各ワーカーノードに物理GPUが固定的に搭載されている必要がありました。しかし、LIQID CDIを組み合わせることで、LIQID CDIのPCIe拡張シャーシに集約されたGPUをプールされたリソースとして使用出来るようになり、KubernetesのPodの要求に応じて動的に接続(コンポーズ)・解放(ディスアグリゲート)することが可能になります。
これを実現するのが、Kubernetes上で動作する専用のコントローラー「LIQID Kubernetes Composer」です。
連携の仕組み
1-1:Podのデプロイと保留(Pending): Helmなどを利用して、NVIDIA NIMなどのAI推論コンテナ(Pod)をKubernetesクラスターにデプロイします。この時点ではノードにGPUが割り当てられていないため、Podは一時的にPending(保留)状態になります。
1-2:LIQIDプラットフォームによるリソース確認とGPU構成: LIQID ComposerがPending状態のPodを検知し、指定されたリソース要件(GPUの数量やモデルなど)を確認します。
1-3:ハードウェアのホットプラグ: LIQIDのオーケストレーション機能により、必要なGPUが対象ノードへ即座に接続(コンポーズ)され、必要なGPUが割り当てられたベアメタルが構成されます。
1-4:ノードの自動更新とPodの実行: NVIDIA GPU Operatorを通じて新しいハードウェア構成がノードラベルに反映されると、Kubernetesが自動的にPodのスケジュール・実行を進めます。
1-5:リソースの自動回収(Reclaim): ワークロード(Pod)の処理が完了し、ノードが一定期間アイドル状態になると、Composerが自動的にGPUを解放(ディスアグリゲート)、フリープールへ戻します。
- Kubernetes側での柔軟な指定方法
LIQID CDIとKubernetesの連携では、通常のKubernetesマニフェスト(YAML)を変更することなく、標準的な記述方法で柔軟なリソース制御が可能です。
GPU数の指定: Podのスペック(resources.limits)に [nvidia.com/gpu](https://nvidia.com/gpu): “2” のように記述するだけで、必要な数のGPUが動的に割り当てられます。
GPUモデルの指定(Node Selector): nodeSelector を使用して [nvidia.com/gpu.product](https://nvidia.com/gpu.product): “Tesla-T4” や “NVIDIA-A100-PCIE-40GB” などのモデルを指定すれば、Composerが自動的に該当するGPUモデルを検知し、構成を行います。
ノードの直接指定(Pod-to-Node Control): kubernetes.io/hostname セレクターを併用することで、特定のブレードサーバー(例: blade-slot-2)を指名してハードウェアを構成することも可能です。
- GPUスプリッティング(分割・共有)への対応
LIQID CDI環境上のKubernetesでは、1つの物理GPUを複数のワークロードで効率的に共有する高度な機能もサポートされています。NVIDIA GPU Operatorの構成(ConfigMap)と組み合わせることで、以下の3つの方式を利用できます
〇 MIG(Multi-Instance GPU): 物理GPU(A100など)を空間的に完全隔離された複数のインスタンスに分割し、それぞれを独立したGPUとして安全に割り当てます。
〇 MPS(Multi-Process Service): 複数のプロセス間でGPUの演算リソースを多重化し、動的に共有します。
〇 タイムスライシング(Time-Slicing): 時分割方式により、複数のPodが順番にGPUを利用することでオーバーサブスクリプション(リソースの超過割り当て)を可能にし、軽量なタスクの利用効率を高めます。
- 導入の主なメリット
ハードウェア利用率の最大化: 必要なときだけGPUを割り当て、不要になればプールへ戻すため、ハードウェアの遊休時間を無くし、投資対効果(ROI)を最大化します。
多様なAIモデルへの柔軟な適応: 軽負荷な8Bモデルから、大規模な70B・405Bモデルまで、モデルの規模や要件(レイテンシ重視かスループット重視か)に応じて最適なGPU構成を動的に組むことができます。
運用管理の効率化: ベアメタルインフラストラクチャの物理的な組み替えをKubernetesのAPI・エコシステム(Helm等)と完全に統合することで、運用の効率化を大きく向上させます。
- LIQID CDIとKubernetes Clusterの接続構成例
LIQID CDIのトポロジーで、Kubernetesの使用を検討する際、最小構成での接続イメージは以下のようになります。
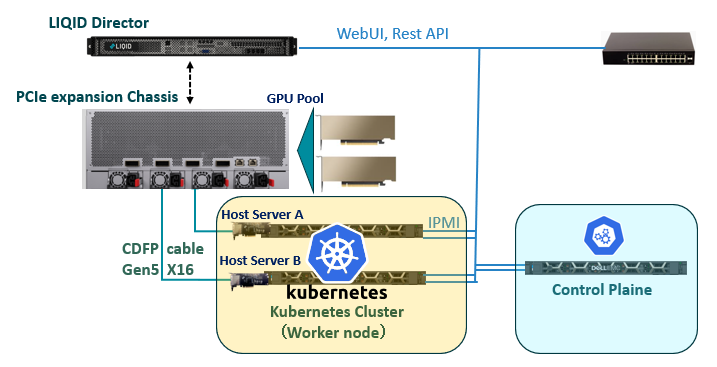
〇 ホストサーバA & B: Kubernetesのワーカーノードとして稼働します。各サーバにはLIQIDファブリックへ接続するためのHBA(Host Bus Adapter)が搭載され、CDFPケーブル(PCIe Gen5 x16)でPCIe拡張シャーシと接続されます。
〇 GPUプール: PCIe拡張シャーシにGPU(PCIeデバイス)が集約されます。LIQID Matrixにより、このCDIファブリックに接続されているホストサーバへ、必要な時に動的に接続(コンポーズ)され、作用が終わると解放(ディスアグリゲート)されます。ホストサーバが4台以上の場合は拡張シャーシとホストサーバの間にPCIeスイッチを介してファブリック接続が行われます。
〇 LIQID Director: 全体のハードウェア構成を管理するCDIの管理ノードです。Kubernetes上の要求に応じて、「今はこのGPUをホストサーバAに接続する」「次はホストサーバBに切り替える」といった動的な接続制御(Compose)を裏で実行します。
6. 動作の仕組み:この構成で何ができるのか?
ホストサーバが2台接続されているので、LIQID CDI本来のダイナミックなリソース移動が検証可能になります。
① クロスホストでの動的なGPUアタッチ
- シナリオ例:
- 最初は、ホストサーバAで動くAI推論のPodのために、ファブリックプールからGPUを2枚ホストサーバAに割り当てて実行します。
- 次に、ホストサーバAの作業が終わりGPUがプールへ返却された後、今度はホストサーバBで立ち上がった別のPodの要求に応じて、同じGPUを今度はホストB側へ動的に接続(コンポーズ)して稼働させることができます。
- メリット:
- 「GPUをあらかじめ各サーバーに2枚ずつ(計4枚)固定購入して遊ばせておく」必要がなくなります。「2台のサーバで、2枚のGPUを必要に応じて融通し合う(プール共有)」という、CDIの最大のメリットであるハードウェアコストの削減と高効率化をそのまま体感できます。
② Kubernetesとの連動(LIQID Kubernetes Composerの役割)
- クラスター内には liqid-composer(Helmでデプロイ)が常駐します。
- どちらのホストサーバ上のPodであっても、Kubernetesマニフェストに [nvidia.com/gpu](https://nvidia.com/gpu): “1” や nodeSelector が記述されていれば、Composerが空き状況を判断し、適切なホストサーバに対してLIQID Director経由でGPUをアタッチさせます。
このように「ホストサーバ2台 + GPU 2枚」の最小構成でも、LIQID CDIの動的オーケストレーションとKubernetesのオートメーションを最もシンプルかつ無駄なく実証できる環境となります。
LIQID CDIをKubernetes環境に連動させたホワイトペーパーは、こちらからご覧になれます。
Inference-as-a-Service with Composable Kubernetes