“Just a Bunch of ~”から考える、メモリ・ウォールを解消する”JBOM”
JBOD、JBOF、JBOGを経て、メモリはついに「共有する資源」になる
AI、HPC、データベース――
これらのシステムを構築するとき、私たちは長い間、「1台のサーバーにCPU、メモリ、ストレージ、アクセラレータを搭載する」という考え方を基本としてきました。
★必要な性能が増えれば、より大きなサーバーを買う
★CPUが足りなければCPUを増やす
★メモリが足りなければDIMMを増やす
★ストレージが足りなければSSDを増やす
★GPUが足りなければGPUを増やす
一見すると当たり前の方法です。しかし、AI時代になって、この「サーバー単位でリソースを持つ」という考え方に大きな無駄が見えてきました。その背景を理解するうえで興味深いのが、
JBOD → JBOF → JBOG → JBOM
という、「Just a Bunch of ~」の系譜です。これは単なる略語の変化ではありません。コンピューティングリソースを、サーバーから切り離してプールするという思想が、ストレージからGPU、そしてメモリへと広がってきた歴史と見ることができます。
1.最初は「ディスクをサーバーから外す」だった ― JBOD
最初の「Just a Bunch of ~」として広く知られているのが、
JBOD(Just a Bunch of Disks)
です。JBODは、多数のディスクを1つの筐体にまとめ、サーバーから外付けで利用するという非常にシンプルな発想です。重要なのは、ディスクをサーバー本体に固定しなかったことです。サーバーとストレージを分離することで、
* サーバーごとに大量のディスクを搭載する必要がない
* ストレージ容量を独立して拡張できる
* サーバーとストレージの構成を柔軟に変更できる
というメリットが生まれました。つまりJBODは、「ストレージはサーバーの一部でなくてもいい」という発想の一つの象徴だったと言えます。
2.HDDからSSDへ ― JBOF
そしてストレージの主役がHDDからフラッシュ/SSDへ移っていくと、次の「Just a Bunch of ~」が登場します。
JBOF(Just a Bunch of Flash)
です。
特にNVMe SSDの登場によって、この考え方はさらに重要になりました。Facebook(現Meta)は2016年、NVMeベースのJBOF「Lightning」を発表しています。多数のフラッシュを1つの外部リソースとして構成し、複数のアプリケーションに対してストレージ容量を柔軟に割り当てるという考え方です。
ここで大きな変化が起きます。単純に「外付けSSDを増やす」のではありません。サーバーとストレージの構成比を、より自由に変えられるようにする。例えば、
* CPUは大量に必要だがSSDはそれほど必要ないサーバー
* CPUは少ないが大量のSSDを必要とする処理
* 一時的に大量のストレージ性能が必要になる処理
があったとしても、サーバーごとにSSDを最大量搭載しておく必要がなくなります。
ここで初めて、「リソースを所有する」のではなく、「必要なときに使う」という考え方が、ストレージ領域で現実的になってきました。
3.そしてGPUもサーバーから外へ ― JBOG
AI時代に入り、次に「外へ出す」対象になったのがGPUです。
JBOG(Just a Bunch of GPUs)
です。その代表例の一つが、Meta(当時Facebook)のBig Basinです。MetaはBig Basinについて、GPU部分をサーバーのヘッドノードから分離し、外部PCIe接続する構成を採用しました。そして、この構成を自らJBOG ― Just a Bunch of GPUsと呼んでいます。これは非常に重要な転換です。GPUは非常に高価なリソースです。
例えば8基のGPUを搭載したサーバーを10台導入すると、80基のGPUを所有することになります。しかし、本当に80基すべてが常時必要なのでしょうか。ある時間帯には、
Server A:8 GPU
Server B:8 GPU
Server C:2 GPU
Server D:0 GPU
という状態になっているかもしれません。それでも従来型サーバーでは、GPUは各サーバーに固定されています。JBOGの思想は、この固定を解きます。
GPUを「サーバーの部品」から「データセンターの共有リソース」へ変える。
ここに現在のComposable Infrastructureにつながる重要な思想があります。
4.LIQID CDIが示してきたもの
この考え方をさらにソフトウェアで発展させた例として、LIQID CDI(Composable Disaggregated Infrastructure)があります。
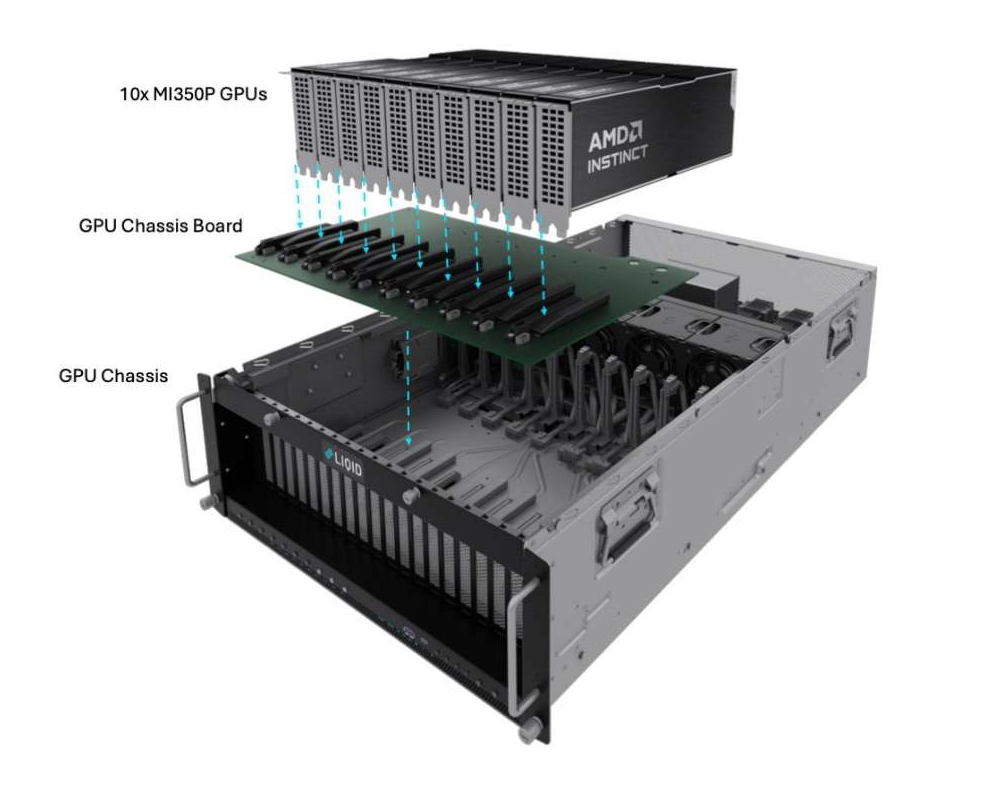
図:LIQID CDI GPUプーリング・シャーシ EX5410P
LIQIDのアーキテクチャでは、GPUだけでなくNVMe SSDなどのリソースをPCIeファブリックの下に配置し、必要な構成を動的に組み立てることができます。過去のLIQIDの構成では、JBOGとしてGPUを外部エンクロージャに配置し、ホスト側から必要なGPUを構成する例も示されています。ここで重要なのは製品そのものではありません。重要なのは、
「サーバーを買う」のではなく、「必要なリソースからサーバーを構成する」
という発想です。これは従来のサーバー調達モデルとはかなり違います。
5.では、なぜ次は「Memory」なのか?
ここからが、現在JBOMを考えるべき最大の理由です。
GPUについては、GPUは高価だから、必要なときに必要なだけ使いたい。という考え方が理解しやすいでしょう。しかしAIインフラでは、もう一つ大きな問題があります。
メモリです。
特に、
* 大規模RAG
* Vector DB
* Graph DB
* インメモリデータベース
* 大規模AI推論
* 長コンテキスト処理
* AIエージェント
* HPC
などでは、データセットそのものが巨大化しています。GPUの演算性能がいくら向上しても、必要なデータを十分な速度でGPUへ供給できなければ、GPUは待たされます。つまり、
「GPUが速すぎる」のではなく、「GPUにデータを供給する側が追いつかない」
という問題が出てきます。
実際、Primemasも現在のAIインフラにおける問題を「computeではなくdataがボトルネックになっている」と位置付け、Direct Attached Memory → Switchless Pooled Memory → JBOMという段階的なメモリ・ディスアグリゲーションを提案しています。
6.メモリを「外に出す」CXL
ここで登場するのがCXL(Compute Express Link)です。
CXLはCPUとメモリ、アクセラレータなどを高速に接続するためのインターコネクトですが、重要なのは単なる「高速な外付けメモリインターフェース」ではないことです。
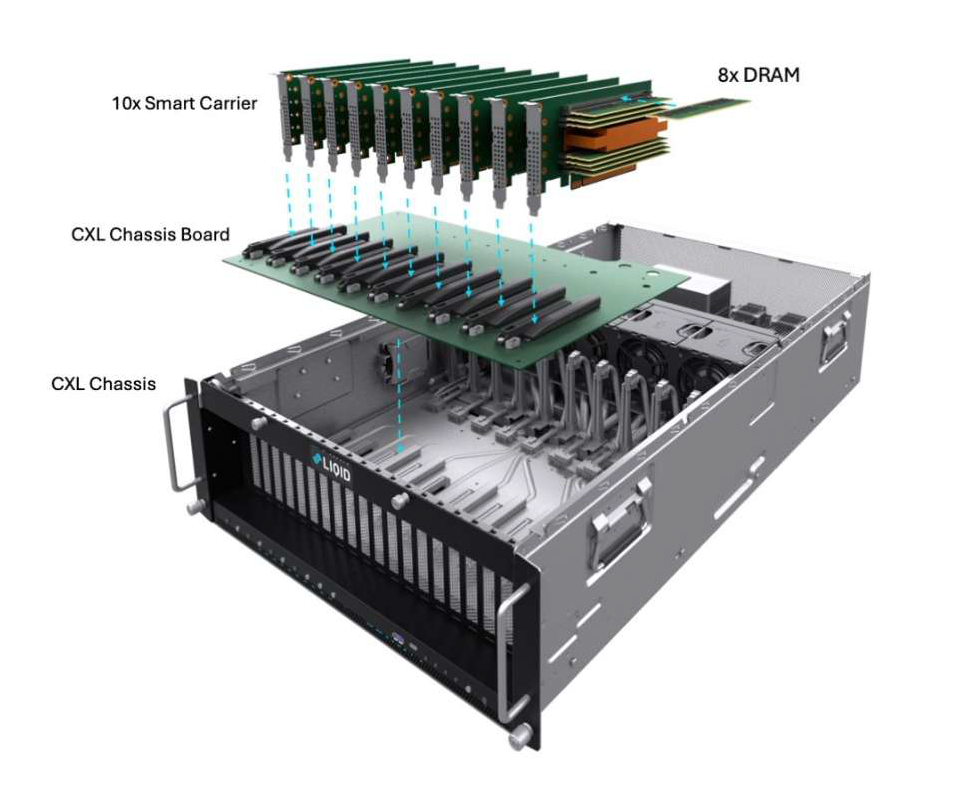
図:LIQID CDI CXLメモリ・プーリング・シャーシ EX5410C
CXL 2.0では、スイッチを使ったリソースのファンアウトやメモリプーリングが標準化され、複数のホストに対してメモリリソースを割り当てるためのFabric Managerも定義されました。つまり、
メモリもサーバーから切り離せる。
ということです。これは非常に大きな意味を持ちます。
7.JBOM ― Just a Bunch of Memory
そして登場するのが、
JBOM(Just a Bunch of Memory)
です。
JBOMとは、多数のメモリデバイスをCXLなどで接続し、巨大なメモリプールとして構成するアーキテクチャです。CXL Consortium自身も、JBOMをCXL Fabricにおけるメモリプールの実装例として説明しています。Fabric Managerがホストに対して必要なメモリリソースを割り当てる構成です。ここで、JBODから始まった流れをもう一度見てみましょう。
| 世代 | リソース | 発想 |
| JBOD | HDD | ドライブをサーバから分離 |
| JBOF | Flash/SSD | 高速ドライブを分離・共有 |
| JBOG | GPU | 高価なアクセラレータを分離・共有 |
| JBOM | DRAM/Memory | 大容量メモリを分離・プール |
この表を見ると、コンピュータアーキテクチャの進化の必然性が見えてきます。
8.実は「容量不足」だけの話ではない
JBOMを「サーバーのメモリを増やす箱」と考えると、本質を見誤ります。JBOMの本当の価値は、
メモリ容量を増やすことではなく、メモリをリソースプールにすることにあります。例えば従来型サーバーで、
Server A:2TB
Server B:2TB
Server C:2TB
Server D:2TB
とメモリを搭載したとします。ところが実際のワークロードが、
A:1.8TB
B:0.5TB
C:0.4TB
D:0.6TB
しか使っていなければ、合計8TBのメモリを購入しているにもかかわらず、かなりの容量が遊んでいます。
逆に、一時的にServer Aだけが4TB必要になったとしても、Server Aに物理的に搭載できるメモリ容量が限界なら、別の方法を考えなければなりません。JBOMでは、この考え方を変えます。
「各サーバーに最大容量を積む」のではなく、「必要な容量をプールから割り当てる」。
これがResource Poolingです。
9.JBOMは「巨大なRAMディスク」ではない
ここは特に注意したいところです。JBOMを、「100TBのRAMを搭載した巨大なサーバー」と考えるのは正確ではありません。JBOMの本質はメモリのディスアグリゲーションとプーリングです。
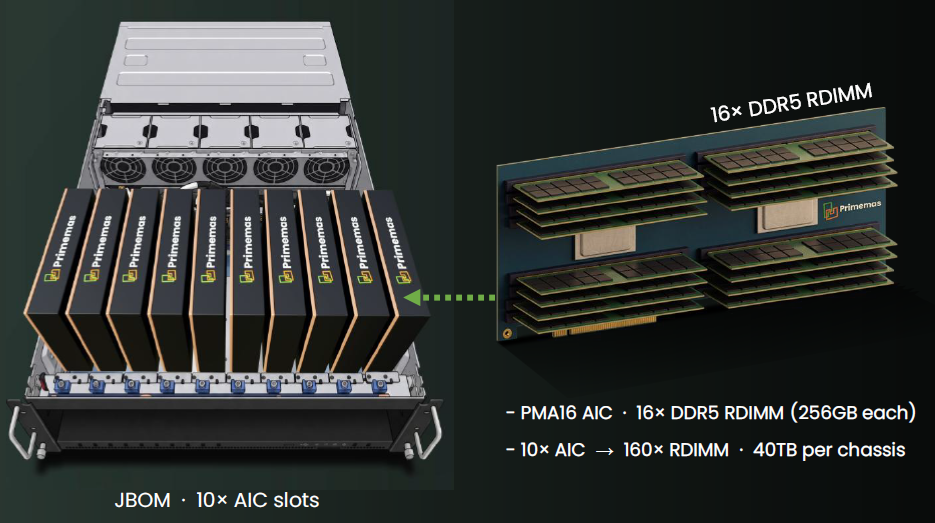
図:Primemas JBOM PMA16 AIC x 10
例えばPrimemasが現在説明しているJBOMも、複数のCXLメモリカードを大きな共有メモリプールとして構成するものです。同社は2026年に40~120TB級、さらに240TB以上へ拡張するロードマップを示しています。そして重要なのが、
「Pooling」と「Sharing」は同じではない
という点です。CXL 2.0では、リソースを複数のホスト間でプールし、必要に応じて割り当てることが可能になりました。さらにCXL 3.0では、ハードウェアコヒーレンシを利用したMemory Sharingという概念も導入されています。したがって、JBOMを検討するときには、「何TBあるか」だけではなく、「そのメモリを何台のホストが、どのように利用できるのか」を見る必要があります。
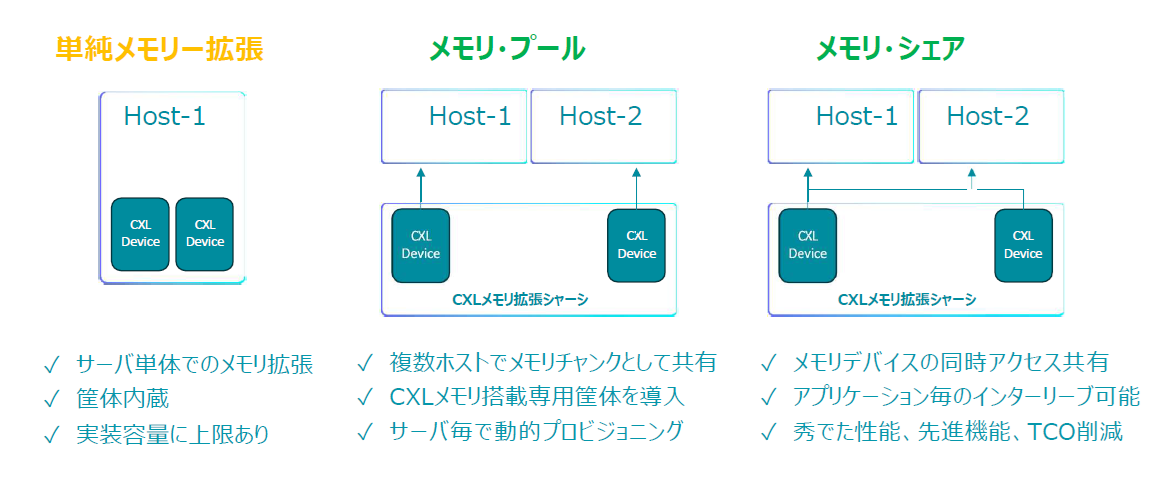
図:CXLメモリの実装方法の選択肢概略(概念図)
10.なぜ「今」JBOMなのか
ここが、このコラムで最も伝えたいポイントです。JBOMは単なる新しいCXL製品ではありません。AIによって、メモリの経済性が変わり始めているからこそ、今検討する価値があります。これまでのサーバー設計では、
CPU性能 × メモリ容量 × ストレージ容量
を一体として考えるのが普通でした。しかしAIでは、
GPU性能 × GPUメモリ × CPUメモリ × ストレージ × ネットワーク
という複雑なリソース構成になります。しかも、それぞれのピークが一致するとは限りません。
☆GPUが暇なのにメモリが足りない。
☆メモリは余っているのにGPUが足りない。
☆ストレージには大量のデータがあるのに、CPUメモリに載せられない。
こうした「リソースのミスマッチ」が増えています。だからこそ、リソースを固定するのではなく、プールするという考え方が重要になります。
11.JBOMが特に面白いのは「AI Database」
JBOMを検討する際、単純な「メモリ増設用途」だけを見るべきではないと考えます。むしろ面白いのは、
AI × Database
です。例えばRAGを考えてみます。RAGでは、
Storage → Database → CPU Memory → GPU
というデータ供給経路が存在します。データ量が小さければ問題ありません。しかし、
* Vector DB
* Graph DB
* 文書データ
* Embedding
* Metadata
* KV Cache
* 長期記憶
* 大規模ナレッジベース
などが増えてくると、SSD上のデータを必要なときに読み出すだけではボトルネックになります。そこで、「頻繁に使うデータをDRAM上に置いてしまう」という発想が出てきます。つまりJBOMは、「巨大なAIデータベース用メモリ層」として考えることができます。実際、PrimemasもJBOMの主要用途としてAIおよび大規模データベースを挙げています。
12.「GPUを増やす」だけではAIインフラは速くならない
これは今後かなり重要になるポイントだと思います。AIサーバーを高速化しようとすると、どうしても、GPUを増やそうとなります。しかし、GPUを増やせば増やすほど速くなるとは限りません。GPUがデータを待っている時間が増えれば、GPUを追加してもそのGPUがアイドルになるだけです。つまり、GPU utilizationを上げるためには、GPUそのものだけではなく、GPUへデータを供給するメモリ階層も考えなければならない。ここで、
JBOG → JBOM
という流れが意味を持ってきます。GPUをプールするだけではなく、GPUが仕事をするための巨大なデータ供給側もプールする。これが、次世代AIインフラの一つの方向性ではないでしょうか。
13.では、すべてのサーバーをJBOMにすべきなのか?
もちろん、そうではありません。JBOMは「大容量メモリなら何でも解決する」技術ではありません。導入を検討するなら、少なくとも次のようなワークロードが候補になります。
JBOMとの相性が良い可能性がある領域
* 大規模RAG
* Vector DB
* Graph DB
* インメモリDB
* 大規模AI推論
* 長コンテキストLLM
* AIエージェント
* 大規模データ分析
* HPC
* 大規模シミュレーション
* 複数サーバー間でメモリ需要が大きく変動する環境
逆に、
* 小規模な一般業務サーバー
* メモリ容量が常に一定のサーバー
* 極端に低レイテンシが要求されるワークロード
* CXL対応プラットフォームを用意できない環境
などでは、従来型のローカルDDR5のほうが合理的な場合もあります。つまりJBOMは、「メモリを増やすための製品」ではなく、「メモリをどう調達・配置・利用するかを見直すためのアーキテクチャ」として評価するべきでしょう。
14.そして、日本でも「JBOMを検討する時期」に入った
これまで日本のCXL市場では、「CXLって結局何に使うの?」という段階が長く続いてきました。CXL Memory AICをサーバーに挿してメモリを増やす――という用途は比較的理解しやすい一方、「なぜわざわざ外にメモリを出すのか?」という疑問も当然あります。しかし、AIによってサーバー内のリソースバランスが大きく変わり始めています。
GPUは高価になり、AIデータベースは巨大化し、RAGやAIエージェントによってCPU側で扱うデータも増えています。その結果、「CPUサーバーに2TBのDDR5を積んでおけば十分」という前提自体を見直す必要が出てきました。
CXL 2.0以降のMemory Pooling、そしてCXL 3.xで広がったFabric/Sharingの考え方によって、その選択肢が現実になりつつあります。
16.JBOMを「メモリ製品」ではなく「インフラの新しい層」として考える
JBOMを検討するとき、重要なのは、「何TBのメモリを搭載できるか」だけではありません。見るべきなのは、
- 何台のホストから利用できるのか
- どのCXL世代に対応するのか
- どのようにメモリを割り当てるのか
- 動的な再構成が可能なのか
- レイテンシはどの程度なのか
- CPUローカルDRAMとの使い分けはどうするのか
- GPUとのデータ供給経路をどう設計するのか
- OS/ハイパーバイザー/DB/AIソフトウェアがどう認識するのか
- 障害時にどのようなRASが働くのか
- 従来型サーバーを何台減らせるのか
です。つまり、「メモリ容量」ではなく「インフラ全体のTCOとResource Utilization」で評価する。これがJBOMを導入する際の重要な視点になります。
17. 終わりに
「Just a Bunch of ~」が示してきた未来
JBOD、JBOF、JBOG
これらの名前には、共通する思想があります。それは、「リソースをサーバーに固定しない」ということです。
ディスクを外へ出した。
Flashを外へ出した。
GPUを外へ出した。
そして今、Memoryを外へ出す。
その先にあるのがJBOMです。もちろん、JBOMがすべてのデータセンターを置き換えるわけではありません。しかしAIによって「メモリ容量」「データ供給」「GPU利用率」の関係が変わりつつある今、JBOMは単なる新しいCXL製品カテゴリーとしてではなく、「コンピューティング資源をどこに持ち、どう使うのか」というデータセンター設計そのものを見直すための選択肢として検討する価値があります。これまで、
Compute → Memory → Storage
というサーバー中心の構成で考えてきたインフラを、
Compute / GPU / Memory / Storage
という独立したリソースプールとして捉え直す。その流れの中で、JBODから始まった「Just a Bunch of ~」の思想は、いま再び大きな意味を持ち始めています。こうしたResource Poolingの考え方を実現する技術として、LIQID CDIやCXLベースのJBOMなどがすでに登場しています。
AI時代のボトルネックは本当にGPUだけなのか、その問いを持つことが、JBOMを検討する最初の一歩なのかもしれません。