LIQIDブログ:動的GPU割当てによるAIモデルのパフォーマンス最適化
(以下はLIQID社ホームページに掲載されたブログの弊社和訳です:
Optimizing AI Model Performance Through Dynamic GPU Allocation
人工知能(AI)が進化し続けるにつれ、より強力で柔軟な計算リソースへの需要が高まっています。この分野で最も期待されている進歩の1つが「コンポーザブルGPU」の実装です。コンポーザブルGPUを使用することで、小規模から超大規模に至るまで、さまざまなAIモデルの要件に最も適した形でGPUリソースを動的に割り当てることが可能になり、学習や推論といった多様なワークロードに対応できます。本文書では、コンポーザブルGPUが80億(8B)、700億(700B)、4000億(4000B)パラメータモデルの動的なニーズにどのように応え、GPUの効率性、拡張性、管理性、そしてパフォーマンス最適化を新たな水準へと引き上げるのかを詳しく解説します。
コンポーザブルGPUの理解
コンポーザブルGPUは、コンポーザブル・インフラストラクチャと呼ばれるより広範な技術の一部です。この技術では、計算、ストレージ、ネットワークの各リソースが分離され、ワークロードの要求に応じて動的に割り当てられます。GPUにおいてこれは、特定のタスクに固定のGPUリソースを専有させるのではなく、リソースをプール化し、必要に応じてサーバーへ割り当てることを意味します。この柔軟性は、モデルによって計算能力やメモリの要求仕様が大きく異なるAIや機械学習の分野で特に価値を発揮します。
モデル規模に応じたGPUリソースの適合
AIモデルにはさまざまな規模が存在し、パラメータ数はその複雑性と必要メモリ量を測る重要な指標となります。コンポーザブルGPUを活用することで、デプロイされる多様なモデル規模に合わせてAIインフラストラクチャを最適化できます。
80億(8B)パラメータモデル
80億(8B)パラメータモデルのような小規模モデルは、通常、それほど大きな計算能力やメモリを必要としないタスクに使用されます。これらのモデルは、単一のハイエンドGPUまたは小規模なGPUクラスタ上で効率的に動作します。こうしたモデルにコンポーザブルGPUを活用する最大のメリットは、過剰なリソース割り当てを防ぎ、必要最小限のリソースを正確に割り当てられる点にあります。
例えば、8Bモデルが必要とするGPUメモリはわずか40〜80GB程度です。コンポーザブルGPUを使用すれば、システムは必要なGPUメモリ量だけを正確に割り当てられるため、リソースの利用効率が最適化され、消費電力やコストの削減につながります。
700億(70B)パラメータモデル
700億(70B)パラメータを持つ中規模モデルは、大幅に多くのメモリと計算能力を要求します。これらのモデルでは、およそ350〜700GBのGPUメモリが必要となる場合があります。従来の構成では、複数のGPUを並列に並べ、各GPUが要求メモリの一部を分担して処理する必要がありました。
このようなシナリオで本領を発揮するのがコンポーザブルGPUによるシームレスなスケーリング(拡張)です。システムは複数GPUのメモリを動的にプール化し、モデルの要件に合致する単一の統合メモリ空間を構築できます。これにより、GPU搭載密度の低い複数台のサーバーを管理するという複雑さを回避しながら、70Bモデルに必要なリソースを確実に確保できます。
4000億(400B)パラメータモデル
4000億(400B)パラメータを持つ大規模モデルは、AIの研究開発における最先端の領域を象徴しています。これらのモデルは膨大なメモリ量を要求し、多くの場合2〜4TBを超えます。このようなモデルは従来、大規模なGPUクラスタ上で実行されますが、その管理や最適化は容易ではありません。
コンポーザブルGPUを活用すれば、システムは数十台のGPUが持つメモリと計算能力を単一のサーバーへ集約し、巨大で統合されたGPUプールを構築できます。このアプローチにより、これら極大モデルのデプロイや拡張がシンプルになり、設備投資(CapEx)と運用コスト(OpEx)を削減しながら、最適なパフォーマンスに必要なメモリ空間と計算能力を確実に提供できます。
コンポーザブルGPUのメリット
- リソース効率の向上: 各モデルの具体的なニーズに基づいてGPUリソースを動的に割り当てることで、コンポーザブルGPUは稼働率(利用効率)を最大化します。これにより、消費電力の低減、コスト削減、そしてパフォーマンスの向上を実現します。
- 拡張性(スケーラビリティ): コンポーザブルGPUはリソースのスケールアップ/スケールダウンを容易にし、あらゆる規模のモデルに対応します。モデルの規模や要求仕様が急速に変化するAI研究において、この柔軟性は極めて重要です。
- 管理の簡素化: コンポーザブルGPUの管理は、固定されたGPU構成を運用するよりもシンプルです。リソースの動的な割り当てにより、拡張やリソース確保に伴う複雑さが軽減されます。
- パフォーマンスの最適化: モデルのニーズにリソースを正確に適合させることができるため、コンポーザブルGPUは最適なパフォーマンスを確保し、ボトルネックの発生やリソースの未活用(低稼働)のリスクを低減します。
モデルサイズ vs. GPUメモリサイズ
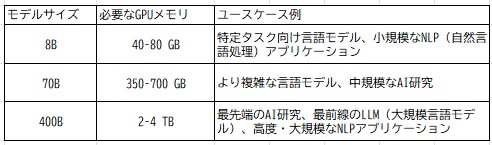
モデルが消費するメモリ量の推定計算式:
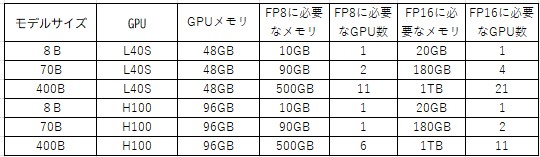
[パラメータ数] × [精度] ÷ 8(ビットをバイトに変換) + [オーバーヘッド分 25%]
例えば、16ビット浮動小数点数(FP16)で学習された8B(80億)パラメータモデルの場合、必要なメモリ量は次のようになります。
8B × 16 ÷ 8 × 1.25 = 20 GB(オーバーヘッドを含む)
モデルサイズ vs GPU数
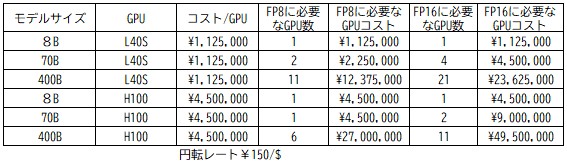
モデルサイズ vs GPUコスト
結論
コンポーザブルGPUの台頭は、AIコンピューティングにおける大きな飛躍を意味します。GPUリソースを動的に割り当てる柔軟性を提供することで、このアプローチは80億(8B)パラメータの小規模モデルから4000億(400B)パラメータの超大規模モデルに至るまで、AIモデルの多様なニーズに対応します。AIが進化し続ける中、GPUリソースを効率的に管理・拡張する能力は、AIモデルの多様なニーズに対応します。AIが進化し続ける中、GPUリソースを効率的に管理・拡張する能力は、AIアプリケーションの可能性を最大限に引き出す上で欠かせません。こうしたAIの未来において、コンポーザブルGPUは重要な役割を果たすと期待されています。